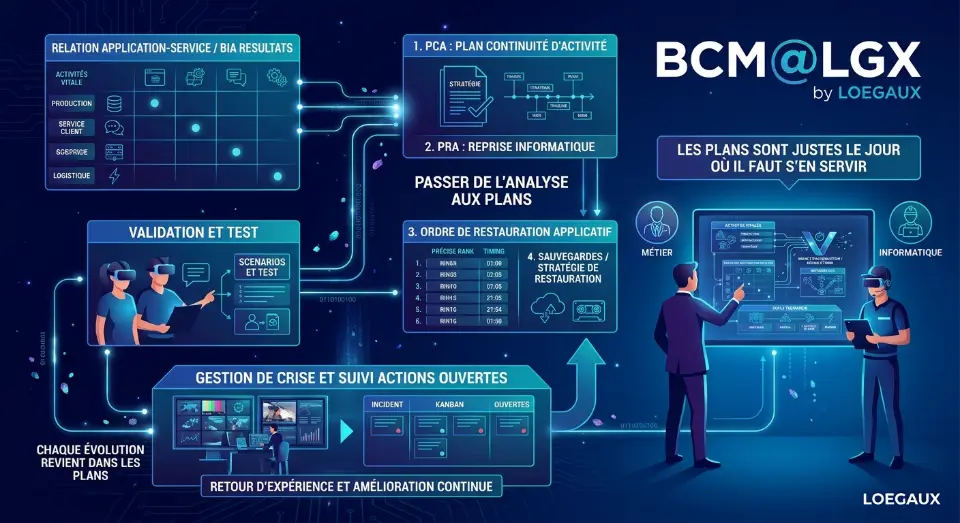
Des plans justes le jour où il faut s’en servir
L’analyse fixe les délais. Les plans disent comment les tenir. L’ISO 22301 demande ensuite de les éprouver, de conduire l’incident, et de les revoir dès que l’organisation change. Un plan qui n’a pas été testé, ou qui ne suit plus le système d’information, ne sert plus le jour de la crise.
BCM@LGX enchaîne ces étapes dans le même projet. Les délais du BIA restent la référence des plans, des sauvegardes et des exercices.
Ce que demande l’ISO 22301
Après l’analyse d’impact, la norme attend quatre résultats.
- Des solutions de continuité choisies pour respecter les délais : contournement métier, reprise informatique, sauvegarde des données.
- Des plans et des procédures. Le plan de continuité d’activité dit comment le métier continue. Le plan de reprise dit comment les systèmes et les données reviennent. Les deux nomment les rôles, les seuils de déclenchement et les étapes.
- Un dispositif de crise : qui décide, qui est joint, comment l’incident est conduit.
- Un programme d’exercices, puis l’amélioration. Chaque écart devient une action. Chaque changement de l’organisation ou du système d’information est repris dans les plans.
La revue de direction constate que ce cycle tourne. C’est le pilotage du système de management de la continuité d’activité.
Ce que BCM@LGX apporte
Chaque livrable s’appuie sur ce qui a déjà été qualifié. On ne réécrit pas les délais à la main.
- Plan de continuité (PCA). À partir du BIA validé, vous décrivez les dépendances, les cinq scénarios et le mode dégradé. L’application rédige le plan du processus. Le délai de mise en œuvre du mode dégradé doit rester dans la DMIA.
- Plan de reprise (PRA). À partir de la fiche application, de son architecture, de ses dépendances et de ses délais, l’application rédige les scénarios et les procédures de remise en service.
- Séquence de restauration. L’ordre proposé place d’abord les applications dont les autres dépendent, puis départage par le délai de reprise. C’est l’ordre à suivre pendant l’incident, et à comparer avec les PRA.
- Sauvegardes. Les propositions de rétention partent des besoins du BIA, en particulier de la perte de données admissible. La conservation quotidienne, hebdomadaire ou mensuelle se justifie par ce besoin.
- Exercices. Vous planifiez des cycles et des tests, de la préparation au retour d’expérience. Un exercice réussi se lit dans le pilotage. Un écart ouvre une action.
- Crise. La cellule, les rôles et le cadre de conduite sont prêts avant l’incident. Les scénarios crédibles sont ceux des plans et des risques déjà décrits.
- Actions et changements. Le pilotage du SMCA garde les actions ouvertes, qu’elles viennent d’un exercice, d’un incident, d’un audit ou d’un changement. Le registre des changements trace ce qui a bougé et doit revenir dans les plans. Les indicateurs du jour peuvent être figés dans une revue de direction.
Comment le conduire
- N’ouvrez les plans qu’une fois les BIA validés. Les délais doivent être stables.
- Rédigez le PCA de chaque processus prioritaire, puis le PRA des applications qui portent ces délais.
- Relisez la séquence de restauration et les propositions de sauvegarde. L’ordre et la rétention doivent être cohérents avec les plans.
- Planifiez un exercice, d’abord sur table, sur un scénario d’indisponibilité. Consignez le résultat.
- Transformez chaque écart en action, et chaque évolution du système en changement.
- Tenez la revue de direction sur les indicateurs du moment : plans rédigés, exercices réussis, actions encore ouvertes, fournisseurs critiques.
Le jour de l’incident, on ouvre le plan qui correspond encore au système réel. C’est le sens de la boucle : analyser, planifier, éprouver, corriger.